Prince Pal: полное руководство по AI в UX research (2026)
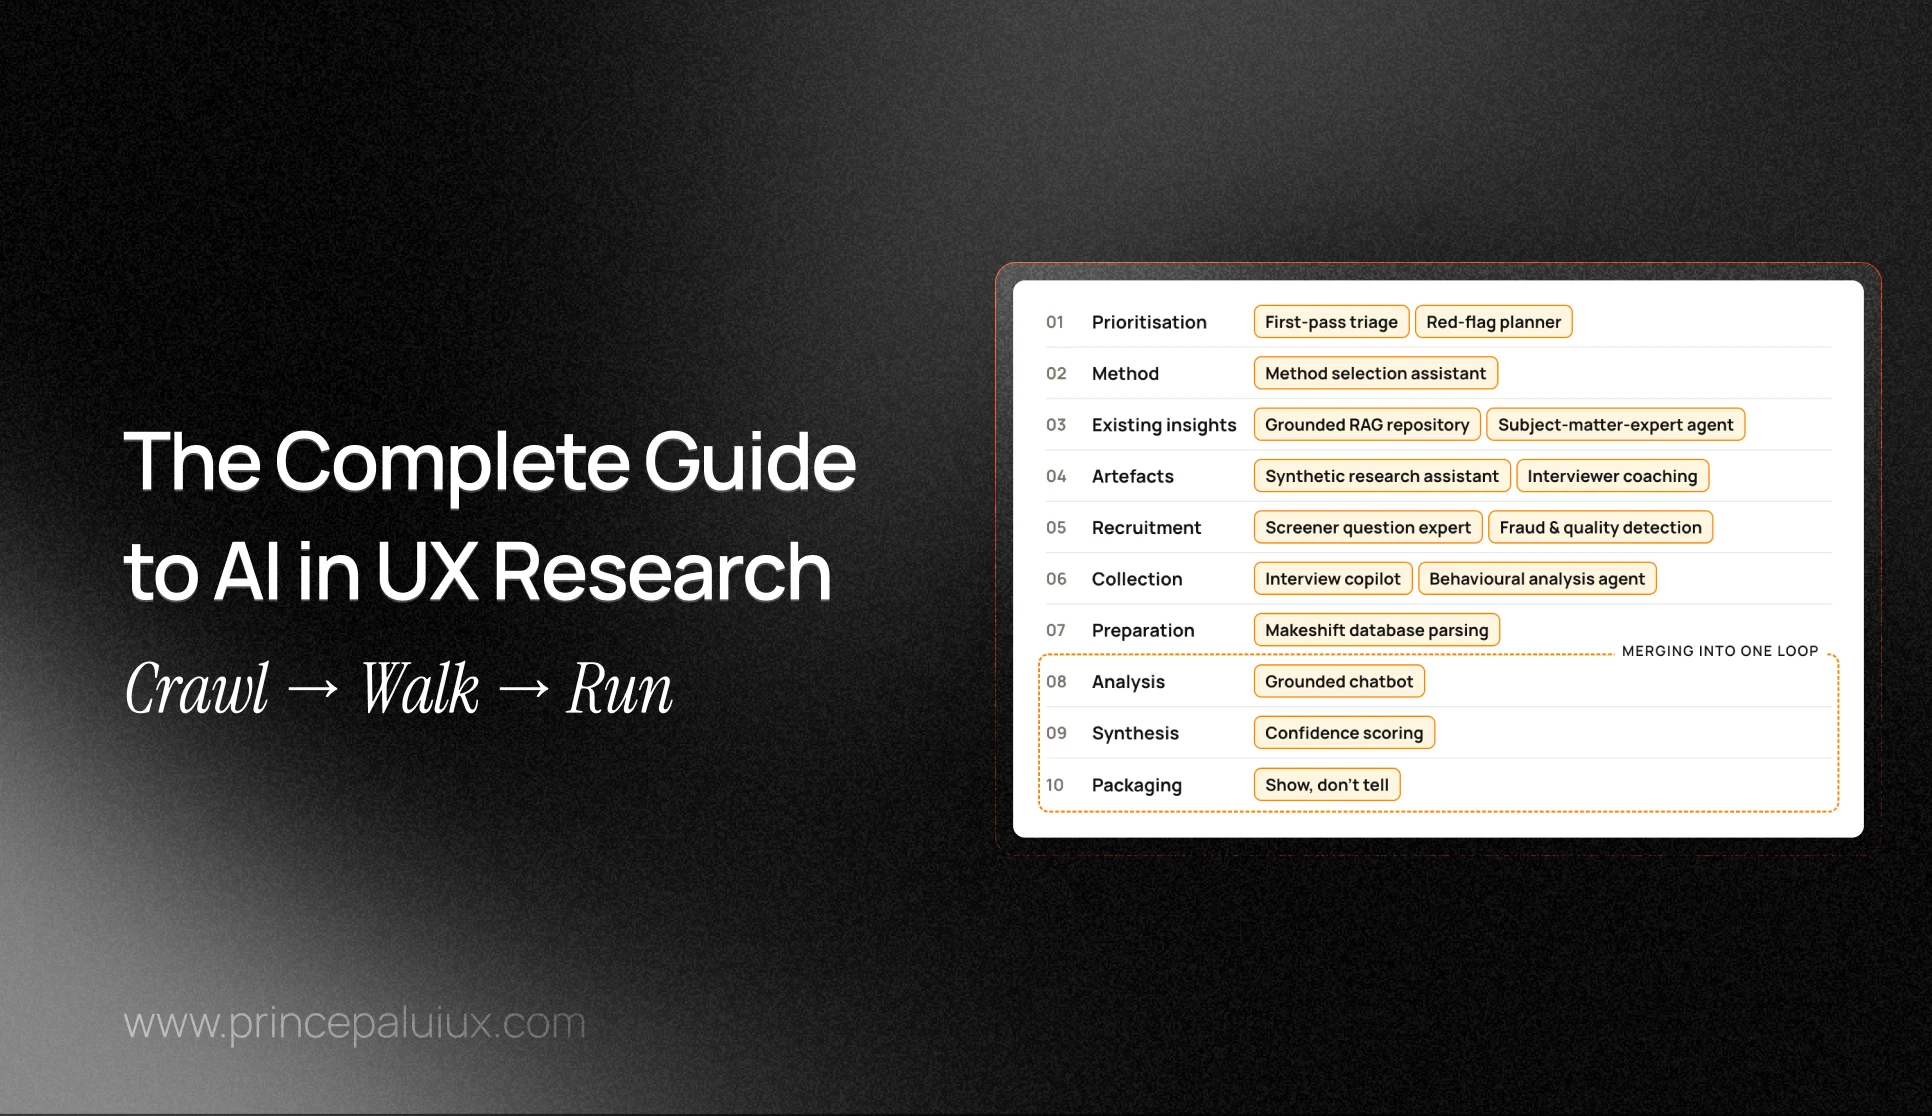
Полное руководство по AI в UX research: Crawl, Walk, Run
Автор: Prince Pal | 9 октября 2026
Почему каждый researcher задаёт этот вопрос
Вы, скорее всего, уже знакомы с этой ситуацией. Кто-то в вашей команде — VP, PM или ваш собственный внутренний голос поздно ночью — спрашивает, как использовать AI в исследованиях. Вы попробовали ChatGPT для гайда интервью. Разрешили AI-транскрибатору поучаствовать в usability-тесте. И всё равно не можете избавиться от ощущения, что делаете это неправильно — или как минимум скромнее, чем все остальные.
Вы не одиноки. Цифры рассказывают странную историю. Согласно отчёту User Interviews State of Research, внедрение AI среди researchers выросло до 80%, прибавив 24 процентных пункта за год, — однако 41% относится к этому негативно. Главные опасения: галлюцинации (91%) и эрозия критического мышления (63%).
Люди используют инструмент и одновременно боятся его. Это состояние высокого принятия при высокой тревоге — то, в котором сейчас живёт большинство research-команд. Именно поэтому карта How to AI UXR от The ResearchOps Review заслуживает внимания. Она не продвигает AI и не осуждает за его использование. Она показывает, что делают реальные команды, систематизированные по уровню зрелости.
Что такое эта карта и почему ей стоит доверять
Вопрос справедливый. Интернет полон статей типа «10 AI-инструментов для UX researchers», написанных людьми, которые никогда не проводили дневниковое исследование.
Эта карта другая. Кейт Тоузи (Kate Towsey), которая во многом определила, как наша область думает о ResearchOps, собрала её на основе 562 точек данных, накопленных с января по май 2026 года. Материал получен из открытых источников, индивидуальных разговоров и трёх рабочих сессий с пятьюдесятью специалистами в области research и ResearchOps, которые активно тестировали границы AI-дополненных исследований. Платформа Strella выступила спонсором.
В методологии есть небольшая деталь, которая заслуживает внимания. The ResearchOps Review рассматривает контент, написанный человеком, как ценность бренда. Там считают, что AI пока не способен писать оригинальные материалы с нужной им глубиной. Но для анализа и синтеза данных они всё же применяли AI, признавая, что было бы лицемерно этого не делать. Процесс требовал тщательной систематической проверки для сохранения строгости.
Запомните эту идею: AI ускоряет работу, а люди сохраняют её честность. Это противоречие пронизывает всю карту.
Подождите, разве мы не договорились, что рабочего процесса исследования не существует?
Здесь есть небольшое противоречие. Большинство researchers скажут вам, что «стандартного рабочего процесса» никогда не существовало. Исследования возвращаются назад. Рекрутинг стопорится. Анализ начинается до последнего интервью. Реальные проекты беспорядочны, и AI делает их ещё более беспорядочными.
Тем не менее карта использует простой линейный рабочий процесс с десятью этапами:
- Приоритизация и roadmapping
- Выбор метода и определение охвата
- Извлечение и повторное использование существующих insights
- Создание исследовательских артефактов
- Рекрутинг участников
- Сбор данных
- Подготовка данных
- Анализ
- Синтез
- Упаковка insights и коммуникация
Зачем использовать модель, с которой все не согласны? Она знакома. Участники решили, что линейный рабочий процесс — это удобный набор крючков, на которые можно вешать новые идеи. Как карта лондонского метро: она географически неверна, и никого это не волнует, потому что она доставляет вас куда нужно.
Интересная часть — это то, что происходит с этими «крючками» по мере взросления команд. Они начинают сливаться друг с другом.
Crawl, Walk, Run: краткий обзор
Карта распределяет все AI-практики по одному из трёх уровней зрелости.
| Уровень | Что делает AI | Кому помогает | Что происходит с рабочим процессом |
|---|---|---|---|
| Crawl | Готовые инструменты помогают с отдельными задачами для отдельных людей | В основном individual researcher | Остаётся почти неизменным. AI делает то, что раньше делал человек |
| Walk | Кастомные агенты, skills и RAG-системы, созданные для команды или организации | Команда и её партнёры | Анализ, синтез и упаковка начинают сливаться |
| Run | Agentic-системы с human-in-the-loop, которые проактивно транслируют research | Вся организация | Этапы сворачиваются в «чёрные ящики», требующие формальных оценок |
Ещё кое-что важное: в карте нет отдельного раздела по ResearchOps. Поначалу кажется, что это упущение, — пока не слышишь обоснование. AI — это технология, поэтому весь AI-дополненный рабочий процесс систематизируется. Иными словами, теперь всё — это operations. Классические «ops»-задачи помечены ключом, но граница между research и ResearchOps стремительно размывается.
Если вы следите за появлением гибридных ролей вроде Human-AI Interaction (HAX) Designer, это покажется вам знакомым. Craft и системы сливаются.
Семь месяцев. Эта цифра не даёт спать
Небольшое отступление к статистике, которая задаёт общий контекст.
Вы знаете закон Мура — старое правило о том, что вычислительная мощность удваивается примерно каждые два года. Карта указывает, что AI-агенты движутся значительно быстрее. По данным исследования METR, длина задач, которые фронтирные AI-агенты могут выполнять самостоятельно с 50-процентной надёжностью, удваивается примерно каждые семь месяцев на протяжении шести лет. Исследователи отмечают, что в 2024 году этот тренд мог ускориться.
Что это значит для вас, сидящего со стопкой транскриптов? Это значит, что карта — это снимок, а не свод правил. Практика, которая сегодня находится на уровне Run, к следующей весне может оказаться галочкой в вашей research-платформе. Тоузи об этом говорит прямо: исследуйте решения с любопытством и осторожностью.
Любопытство и осторожность. Хотелось бы нанести эту фразу на запястье каждому руководителю ResearchOps.
Crawl: когда AI — ваш очень быстрый и немного самоуверенный стажёр
На уровне Crawl люди используют готовые LLM — ChatGPT, Claude, Gemini или Copilot — для черновиков, резюме, кластеризации и упаковки. Также применяют их в качестве партнёров для размышлений. Ничего не систематизировано. Выигрыш носит личный характер и в основном невидим для организации.
Но не стоит путать Crawl с «начальным уровнем». Кое-что важное уже происходит. Этапы, которые раньше следовали один за другим, сжимаются в один разговор с AI. Вы вставляете заметки, задаёте вопрос, получаете резюме, просите набросок слайдов — и за двадцать минут делаете то, на что раньше уходило три отдельных рабочих сессии.
Решение, что изучать (и почему AI — плохой руководитель здесь)
На этапе приоритизации команды используют AI для кластеризации длинных списков research-запросов, оценки проблем из больших массивов клиентских данных и выявления пробелов в знаниях. Некоторые привязывают стейкхолдеров к продуктам, чтобы упростить фильтрацию intake. Другие применяют AI как партнёра для мозгового штурма — поиск пробелов до начала встреч со стейкхолдерами.
Но есть подводный камень. AI склонен подтверждать, а не исследовать. Спросите его: «Это правильный приоритет для research?» — и очень часто получите: «Отличный вопрос, да!» Это приятно. Для приоритизации — бесполезно. Финальное решение по-прежнему остаётся за суждением researcher.
Выбор метода работает примерно так же. AI выступает партнёром один на один для выбора методов и структурирования исследования. Он может оспаривать ваши предположения, переформулировать размытые бизнес-цели в чёткие research-вопросы или создавать шаблоны с учётом бюджета и дедлайна. Полезно? Безусловно. Надёжно? Только настолько, насколько надёжен контекст, который вы ему предоставляете, — потому что на уровне Crawl за ним нет никакой общей системы.
Практический совет: прямо скажите модели, что она должна с вами не соглашаться. «Назовите три причины, почему этот метод неверен» даёт вам гораздо больше, чем «Это хороший метод?»
Что мы уже знаем?
Здесь AI уровня Crawl особенно силён. LLM, вики и репозитории со встроенным AI позволяют значительно быстрее находить существующие insights. Инструменты глубокого research могут проводить то, что по сути является мгновенным literature review.
Несколько паттернов выделяются особо:
Опрос источников. Загружайте документы в инструмент глубокого research, чтобы быстро изучить область, задать вопросы материалу и понять, какие источники заслуживают полного прочтения.
Мультиисточниковое резюмирование. Собирайте insights из разрозненных мест — SharePoint, Confluence, репозитория исследований, инструментов обратной связи с клиентами, — затем группируйте и резюмируйте.
Трюк с проверенными PDF. Используйте инструмент глубокого research для поиска ключевых источников, проверяйте каждый вручную, распечатайте лучшие в PDF, затем загрузите этот отобранный набор обратно в инструмент для дальнейших вопросов.
Замечаете паттерн? Цитаты — это проверка качества. Если инструмент глубокого research не может показать, откуда взялось утверждение, относитесь к нему как к слуху на свадьбе: занимательно, возможно правда, но повторять начальнику не стоит.
Google NotebookLM вызывает много одобрения в этом контексте. Одна команда загружает в него предыдущие исследования и документацию по крупным смешанным методом проектам, картирует известное, отмечает места с противоречивыми данными и составляет список открытых вопросов. Это полноценный roadmap-input, собранный за один день.
Победа над чистым листом
Создание артефактов (планов, скринеров, гайдов интервью, материалов воркшопов) — это то место, где большинство людей впервые ощущают скорость AI. Дайте LLM немного контекста предметной области — записи совещаний, прошлые исследования, внутренние документы — и он набросает план исследования за секунды.
Карта называет это «черновиком с нуля», и она честна в отношении недостатка: результаты обычно требуют значительного редактирования, прежде чем станут пригодными для использования.
Есть и более скрытая проблема. Researchers всё больше времени тратят на помощь нересерчерам в исправлении работы, которая выглядит отполированной, но не является таковой. PM делится красиво отформатированным гайдом интервью, а четвёртый вопрос — leading, седьмой — double-barrelled, и вся конструкция тестирует неверную гипотезу. AI сделал её красивой, но не правильной.
Две практики заслуживают большего внимания, чем получают:
Синтетическое когнитивное тестирование. Попросите LLM сыграть роль персонажа-клиента и прогоните через него активности интервью. Это не заменит настоящий пилот, но быстро выявляет неудобные формулировки. Некоторые инструменты опросов позволяют заполнить опрос тестовыми данными, чтобы предварительно просмотреть итоговые графики до запуска.
Job mapping. Используйте промпты jobs-to-be-done, чтобы набросать структуру рабочего процесса пользователя до начала discovery. На первое интервью вы приходите не с чистой доской, а с картой гипотез.
Рекрутинг в эпоху AI-написанных ответов на скринер
Рекрутинг становится быстрее. LLM составляют аутрич-письма, рекрутинговые объявления и персонализированные приветствия на основе прошлых примеров. Они очищают списки участников, чтобы можно было персонализировать приглашения. Один участник кратко описал отдачу: персонализированные приветствия вроде «Привет, Сара» дают значительно лучший отклик.
AI может даже стать приманкой. Несколько команд используют AI как разговорный крючок для расширения своей панели участников — откровенно говоря, сейчас все хотят обсуждать AI.
Но есть и обратная сторона. По мере того как всё больше заявителей используют AI для заполнения скринеров, распознавание фальшивых или AI-сгенерированных ответов становится частью работы по рекрутингу. Команды применяют AI для маркировки AI-подобных паттернов в заявках — борьба с огнём огнём.
Карта добавляет фразу, которая особенно ценна: человек всё равно должен проверять эти флаги, потому что некоторые люди просто хорошо пишут. Не отклоняйте самого красноречивого участника только потому, что модель решила, что он звучит слишком отполированно.
В процессе: сбор данных
На уровне Crawl суть сбора данных не изменилась. Вы всё так же присутствуете, задаёте хорошие вопросы и молчите достаточно долго, чтобы люди смогли ответить.
Изменилась поддержка вокруг вас. AI делает заметки в реальном времени и резюмирует сессии. Создаёт «сводки» по нескольким сессиям, что помогает замечать паттерны для дальнейшего изучения или пробелы в заметках, пока исследование ещё идёт. Узнать на второй день, что вы забыли спросить о ценообразовании, лучше, чем узнать об этом на этапе синтеза.
Немодерируемые инструменты сейчас имеют встроенные AI-функции, и AI-модерируемые исследования растут. Один интересный кейс — чувствительные темы: некоторые участники открываются больше, когда на другом конце нет человека. Карта чётко формулирует этику: участники всегда должны давать согласие на то, как будут использоваться их данные.
Команды также ускоряют UX-скоринг с помощью Figma-плагинов, таких как Measure UX. Минуты вместо часов.
Подготовка, анализ и синтез начинают сливаться
Подготовка данных раньше была скучным административным этапом. Теперь AI справляется с большей её частью быстро и точно:
- Редактирование персонально идентифицируемой информации (PII) и анонимизация цитат из аудио, текста или видео
- Очистка транскриптов и удаление слов-паразитов
- Переименование файлов в соответствии с вашими конвенциями именования для удобства поиска
- Обогащение тегов метаданных для упрощения поиска insights
- Отсев мусорных данных: пустых ответов и безымянных тестов
На стороне анализа инструменты глубокого research ускоряют путь от сырых данных до insights. Команды применяют AI для тематической кластеризации, создания кодовых книг для больших массивов открытых ответов и автоматической маркировки ключевых моментов в транскриптах. Опытные команды сравнивают AI-кодирование с человеческим для проверки точности. Некоторые разбирают несколько транскриптов в матрицы синтеза для сравнения ответов участников на одинаковые вопросы.
Два предупреждения стоит повторить. Результаты этих инструментов дополнительны, а не исчерпывающи, и требуют проверки. И AI всё ещё не способен надёжно считывать мимику или жесты в видеозаписях сессий. Если ваш анализ опирается на «она замешкалась перед кликом» — это по-прежнему ваша работа.
Лучшие Crawl-практики для синтеза относятся к AI как к партнёру для дискуссии, а не к оракулу:
Запрос против предвзятости. Попросите модель найти выбросы, крайние случаи и противоречивые данные, чтобы противодействовать её склонности переоценивать наиболее громкие темы.
Стратегическое взвешивание insights. Попросите модель оценить силу и релевантность каждой темы и объяснить свои рассуждения.
«Что мы упустили?» Проведите gap-анализ, сравнив результаты исследования с product brief.
Когнитивная поддержка. Researchers с СДВГ используют AI-сгенерированные резюме и списки действий для управления тяжёлой ментальной нагрузкой синтеза. Выигрыш в доступности — одни из самых человечных результатов этой технологии.
Когда исследование низкорисковое или результаты AI были должным образом оценены, некоторые команды сжимают подготовку, анализ, синтез и упаковку в один шаг. На входе — сырые транскрипты, на выходе — actionable insights. Это мощно, и именно здесь привычки проверки важнее всего.
Упаковка: более красивые деки и вопрос подкастов
AI ускоряет написание research-контента и делает возможными новые форматы. Команды применяют инструменты вроде Gamma для создания отполированных деков, где AI предлагает плотность контента и визуалы. Researchers используют LLM для оттачивания языка presentations.
Некоторые команды вручную переформатируют результаты для разных аудиторий: резюме для руководства, резюме по ROI, резюме по рискам или список багов для инженеров. Одни и те же данные — разные двери.
А ещё существуют аудиобрифинги в формате подкастов и видеообзоры (аудиообзоры NotebookLM — очевидный пример). Стейкхолдеры, которые никогда не читают отчёты, вполне могут с удовольствием прослушать десятиминутное резюме в дороге. Устанут ли аудитории от этих форматов, когда новизна пройдёт? Никто пока не знает. Интуиция подсказывает: формат выживет, а вот его дженериковые, однообразные версии — нет.
Тихий сдвиг внутри Crawl
На уровне Crawl кажется, что структурно ничего не изменилось. Те же researchers, те же исследования, просто быстрее. Присмотритесь — и увидите два важных процесса.
Первый: этапы коллапсируют. Подготовка перетекает в анализ. Анализ — в упаковку.
Второй: выигрыш невидим. Когда один researcher экономит шесть часов в неделю, организация этого не замечает. Нет общей библиотеки промптов, нет командного процесса оценки, нет памяти о том, что сработало. Каждый researcher молча изобретает одно и то же колесо в своём чат-окне.
Именно второй момент — настоящая причина, по которой команды переходят на Walk. Дело не в более продвинутых инструментах. Дело в превращении личной скорости в общие системы.
Стартовый набор уровня Crawl:
- Ведите общий документ с промптами — даже если это просто страница в Notion
- Всегда просите AI о противоречивых данных, а не только о темах
- Требуйте цитаты от любого инструмента глубокого research и проверяйте некоторые из них
- Удаляйте PII перед тем, как что-либо попадёт в публичный LLM
- Сравнивайте образец AI-кодирования со своим собственным, прежде чем доверять ему в больших объёмах
Walk: момент, когда команда начинает создавать собственные инструменты
Карта описывает Walk как создание целенаправленных агентов, skills и RAG-систем, расширяющих возможности готового AI. Фокус смещается с «насколько я быстр» на «насколько хорошо работает наша команда». И появляется новая дисциплина, к которой большинство researchers не готовились: evaluations, или evals.
Краткая версия: на уровне Walk вы перестаёте просить AI о помощи и начинаете давать ему работу.
Этот сдвиг многое меняет. Чат-бот, составляющий ваш скринер, — это помощник. Агент, создающий скринеры для каждого дизайнера в компании на основе библиотеки вопросов, которую он собрал сам, — это уже ближе к коллеге. Коллеге, чьи рассуждения не всегда можно отследить.
Карта называет три новых опасения на этом уровне. Синтетические персонажи и AI-модерируемый сбор данных создают «инсайты из чёрного ящика». Существует риск AI data loops — когда AI-созданные результаты возвращаются в систему как входные данные. И части рабочего процесса сливаются, особенно анализ, синтез и упаковка.
Строительные блоки без туманного жаргона
| Термин | Что это | Почему researcher должен это знать |
|---|---|---|
| Agent | AI-система, которая планирует шаги, принимает решения и выполняет действия для достижения цели | Может свернуть многоэтапный процесс в один результат, который сложно отследить |
| Skill | Переиспользуемая структурированная процедура, которую агент или человек применяет к конкретной задаче | Стандартизирует качество и упрощает аудит |
| Custom GPT или Gemini Gem | Предварительно настроенный ассистент с собственными инструкциями и файлами знаний | Распространяет хорошие практики по команде — и ошибки так же быстро |
| RAG | Конфигурация, при которой AI обращается к вашим проверенным источникам перед ответом | Ответы становятся более надёжными, но только если retrieval качественный и цитаты сохраняются |
| Synthetic persona | AI-модель, направленная вести себя как определённый тип пользователя | Удобна для репетиций, рискованна при использовании в качестве реальных данных |
| Eval | Систематический тест точности и надёжности AI по установленным критериям | Без него «выглядит нормально» становится вашим тестом качества |
Ресепшн: трейдж, брифы и выбор методов
У каждой research-команды есть проблема ресепшна. Поступают размытые запросы. «Можем ли мы провести какое-нибудь исследование онбординга?» Что это значит? Это вообще research-вопрос?
На уровне Walk команды создают агентов для работы с этим ресепшном до того, как к процессу подключается researcher:
Агенты первичного трейджа позволяют стейкхолдерам самостоятельно классифицировать собственные запросы.
Агенты написания брифов проводят с дизайнерами интервью об их решениях и неизвестных, затем формируют структурированный бриф. Большинство плохих брифов появляются из-за того, что никто не задаёт правильные уточняющие вопросы — это решает проблему.
«Планировщик красных флагов» прогоняет product-документы через цепочку промптов. Он выявляет непроверенные предположения, отмечает user-чувствительные решения без доказательной базы и формирует ранжированный список research-возможностей.
Intake skills задают вопросы о проекте, затем рекомендуют, как проводить исследование, стоит ли партнёру действовать самостоятельно или говорить с researcher, и стоит ли вообще проводить исследование.
AI, который говорит «вам не нужно исследование для этого», оказывает researcher реальную услугу.
Оригинал статьи — Prince Pal, princepaluiux.com, 9 октября 2026 года. Карта How to AI UXR разработана Kate Towsey / The ResearchOps Review при поддержке Strella.