MeasuringU: раскрывают ли AI-модераторы столько же инсайтов, что и люди?
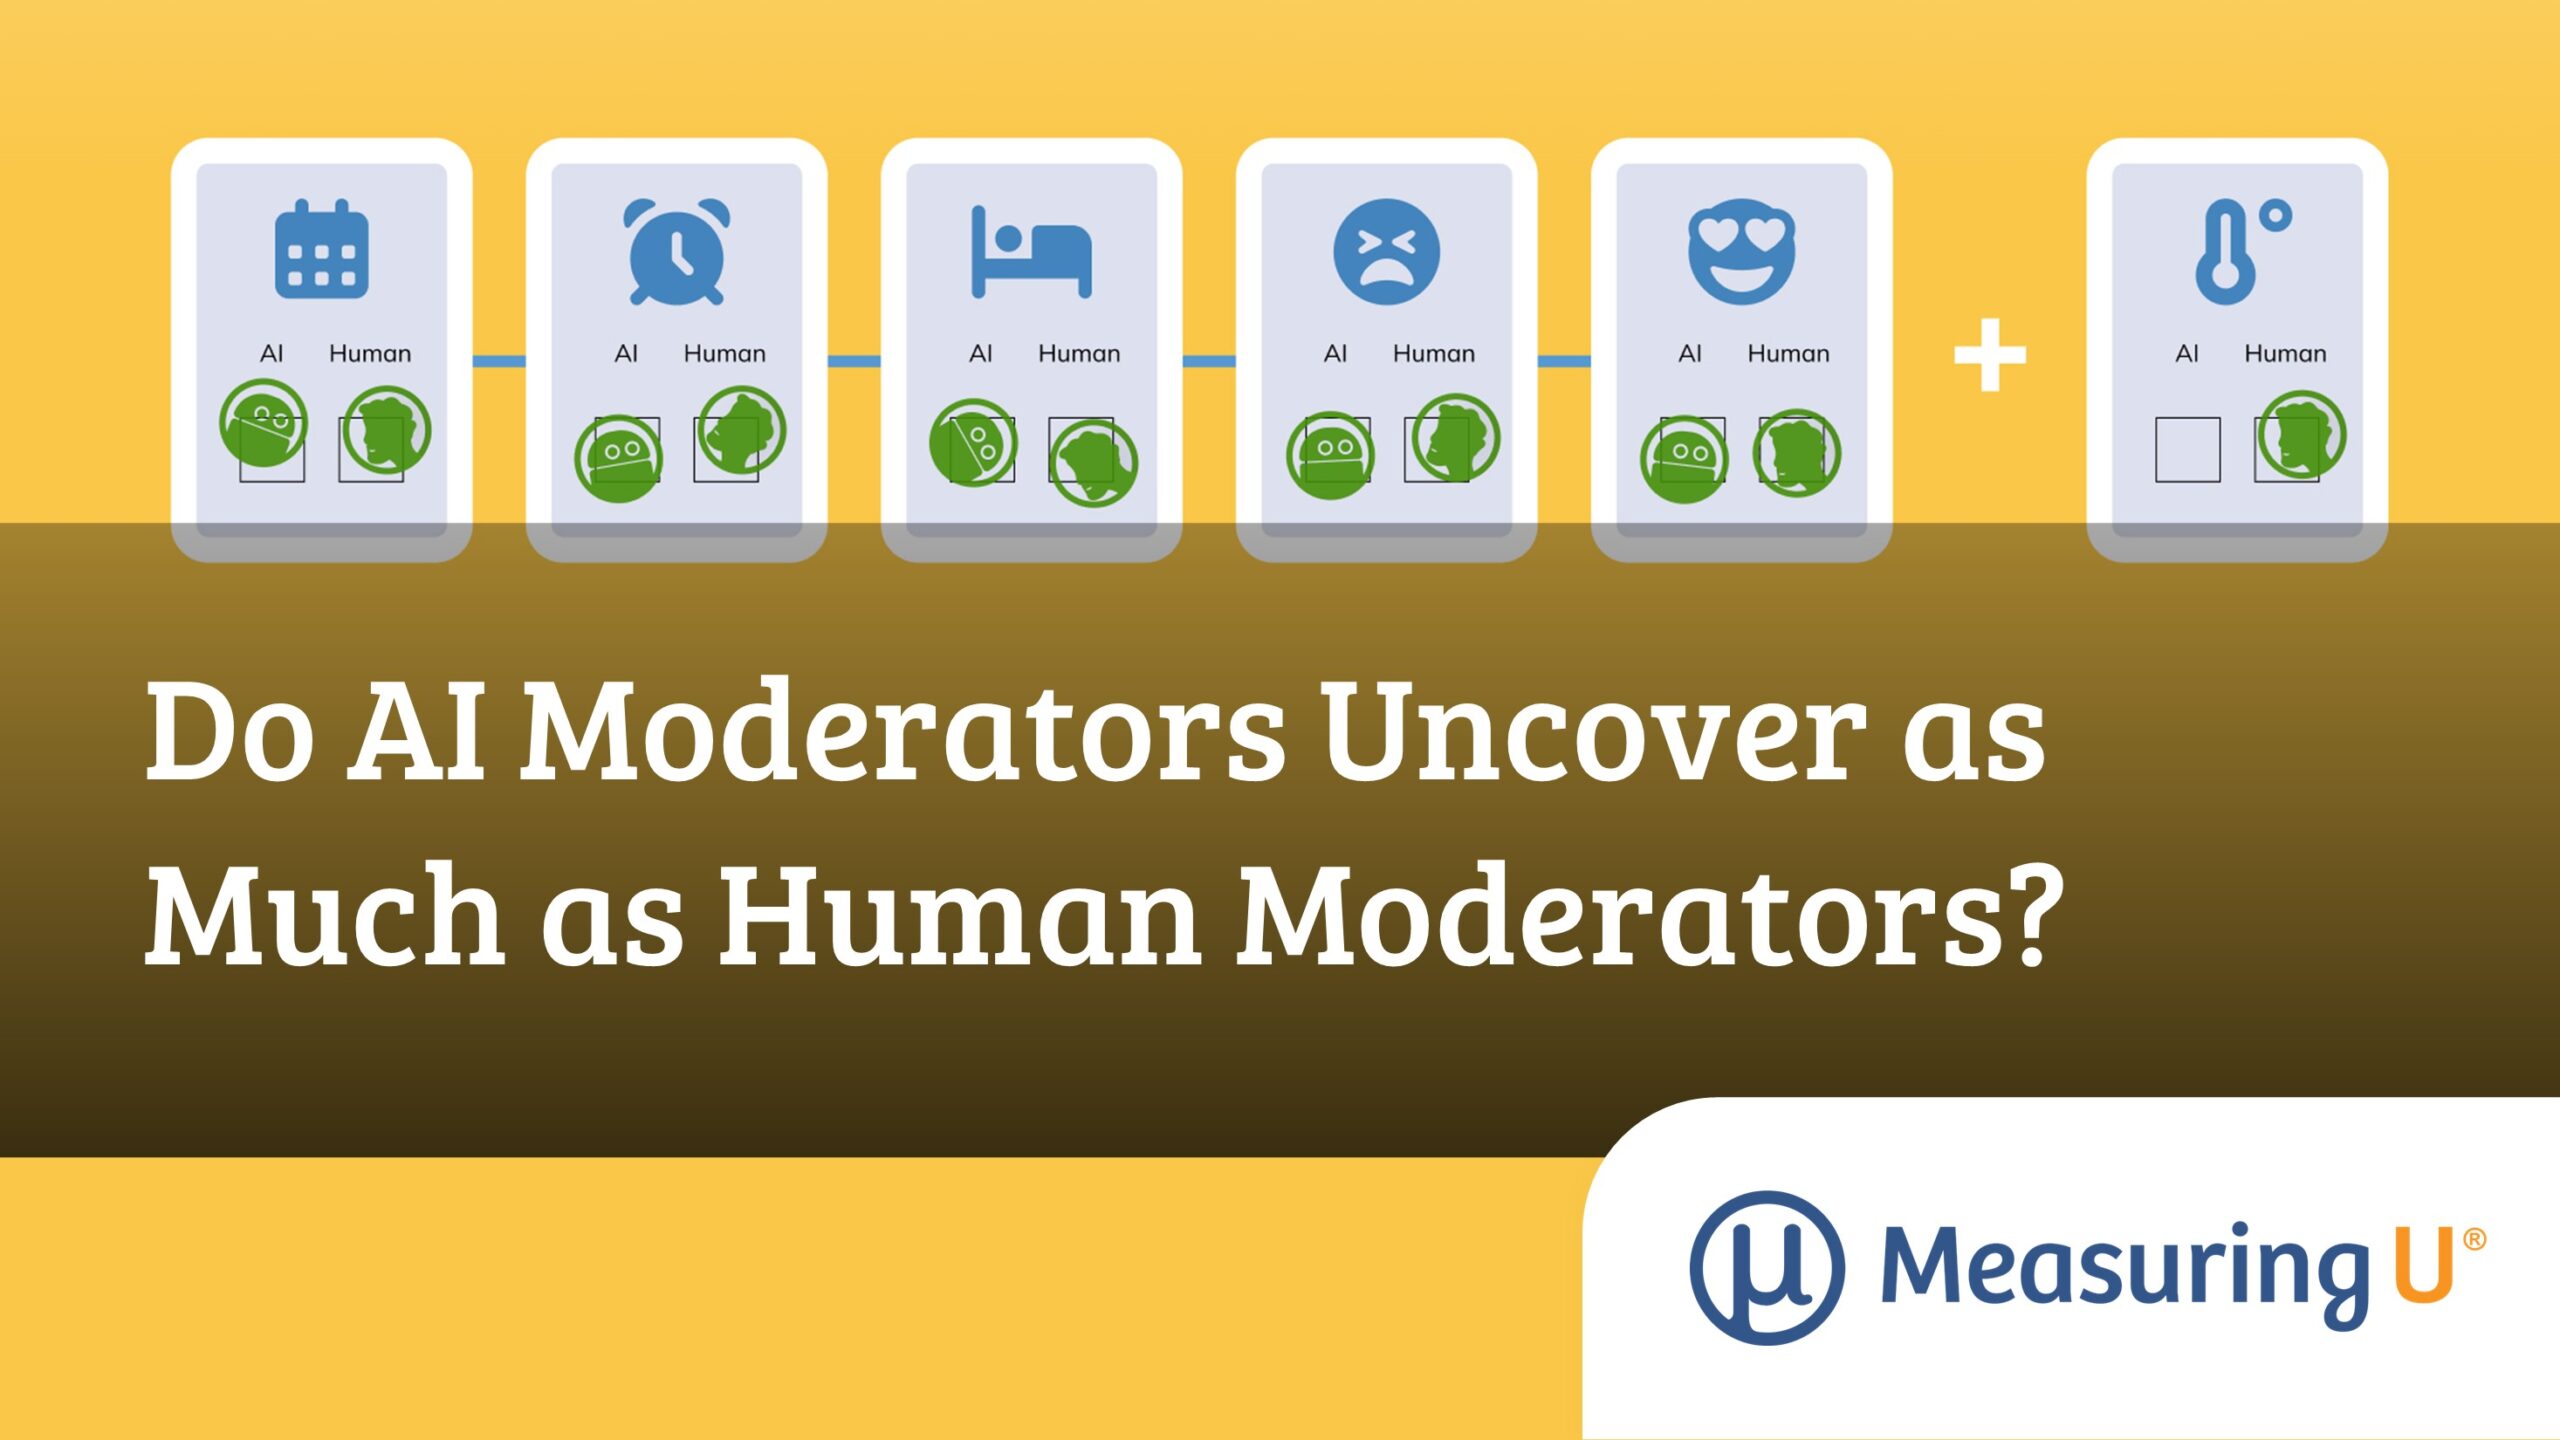
Могут ли AI-модераторы заменить людей в качественных исследованиях? Несколько месяцев назад сам вопрос казался неактуальным, но технологии развиваются быстро. Исследователи из MeasuringU решили не опираться на маркетинговые утверждения, а собрать собственные данные. Джефф Сауро, доктор наук, Ева Сандберг, Лукас Плабст и Джим Льюис провели рандомизированное контролируемое исследование, чтобы ответить на конкретные вопросы: говорят ли участники меньше AI-модератору? Дают ли они ему столь же глубокие инсайты? Насколько AI справляется с проведением интервью?
Устройство исследования
AI-модератора создали на базе Gemini 3 Flash с фотореалистичными аватарами и голосами двух исследователей MeasuringU, которые одновременно проводили живые сессии. Система работала как цепочка агентов: каждый охватывал широкую тему и передавал резюме следующему, создавая у участников ощущение единого разговора.
Двадцать жителей Денвера случайным образом распределили между условиями — AI или человек-модератор — с перекрёстным распределением по полу модератора (схема 2×2, по пять человек в каждой ячейке). Участники сидели в лаборатории MeasuringU, пока модераторы подключались по видео. Пол участников немного склонялся к мужскому, отношение к AI (сторонник, нейтральный, скептик) было относительно равномерным.
Исследование имитировало дискавери-исследование для вымышленной компании, разрабатывающей продукт для управления сном и пробуждением. Цель — найти текущие проблемы и возможности для нового продукта. Это не агрегирование ответов на вопросы анкеты, а реалистичные глубинные интервью, типичные для поискового UX-исследования. Модераторы работали по гайду с пятью блоками вопросов: режим сна, метод пробуждения, условия сна, текущий опыт, идеальное пробуждение.
Два исследователя MeasuringU, не проводившие ни одной сессии, независимо кодировали все 20 транскриптов без заранее составленного списка тем. Claude проверял их кодирование и выступал третьим кодировщиком.
Результаты
Из работы кодировщиков возникли восемь тем. Семь из них зафиксировали и AI, и человеческие модераторы. Наиболее распространённые: биологические часы против расписания и совместный сон (90% сессий), будильники (80%), время как диапазон, а не точка (73%), спальня как инструмент сна и пробуждения (68%). Реже всего встречались идеальное пробуждение (62%) и опробованные и заброшенные гаджеты (38%).
По всем сравнениям: человеческие сессии содержали семь из восьми тем чаще, чем AI-сессии — в среднем на 7–73 процентных пункта. Единственная тема, где AI оказался выше, — будильники (+7 п. п.). В среднем за сессию Claude-кодировщик нашёл 6,9 темы в человеческих сессиях против 5,0 в AI-сессиях (p = 0,004), и человеческие кодировщики показали тот же результат.
При этом AI-сессии были на 37% короче, а участники говорили на 45% меньше слов в минуту (54 против 98). AI достиг большинства тем при вдвое меньшем количестве слов от участников, но несколько реже.
Климат сна: тема, которую нашли только люди
Не все темы равнозначны. Восьмая тема — климат сна — появилась в шести-девяти из десяти человеческих сессий и в нуле-одной из десяти AI-сессий. Разрыв статистически значим для всех трёх кодировщиков (p < 0,01). Гайд ни разу не предлагал модераторам спрашивать про условия в спальне. Несмотря на это, люди-модераторы интуитивно туда заходили — и участники охотно рассказывали о температуре, шуме и свете. Климат сна напрямую связан с целью исследования — поиском новых продуктовых возможностей. Участники в человеческих сессиях рассказывали, например: «У меня есть Bed Jet… он дует тёплым или холодным воздухом… Мы включаем его и утром». AI, напротив, упомянул комнату лишь однажды, в контексте гипотетического вопроса про идеальное пробуждение, и получил в ответ рассказ про запах кофе.
В девяти человеческих сессиях, где тема всплыла, модераторы либо сами открывали её («как насчёт температуры в комнате?», «у вас жалюзи закрыты?»), либо подхватывали её, когда участник упоминал самостоятельно. AI следовал скрипту и не шёл туда, где скрипт молчал.
Насколько сложным был тест
Пять из восьми тем прямо соответствовали пунктам гайда, ещё одна — частично. Это делало тест относительно лёгким: он в основном проверял, насколько хорошо модератор следует скрипту, — и AI справился с этим хорошо. По шести темам из гайда разрыв между AI и человеком составил около 8 п. п. По двум темам, которые гайд не охватывал, разрыв составил 30 и 73 п. п.
Практический вывод исследователей: пишите хороший гайд. Если он охватывает темы — AI-модератор справляется достаточно хорошо, хотя и немного хуже человека. Но дискавери-исследование существует именно потому, что вы не знаете заранее всех вопросов. И провалы AI — не в следовании скрипту, а в тех неожиданных поворотах, которые любопытный человек делает по ходу интервью.
Итоги и ограничения
Выводы рандомизированного исследования с 20 участниками:
— Два независимых кодировщика-человека нашли восемь тем с умеренной согласованностью (κ = 0,38–0,44), Claude проверил их как третий кодировщик.
— AI провёл разумно хорошее интервью, но человеческие модераторы справились лучше: в среднем 6,9 темы против 5,0 на сессию (p = 0,004).
— Люди раскрыли ключевую тему, которую AI упустил. Климат сна появился в 60–90% человеческих сессий и в 0–10% AI-сессий.
— Хороший скрипт сокращает разрыв. Там, где гайд охватывал тему, AI и человек были близки. Там, где нет, — люди вырывались далеко вперёд.
Ограничение: это одно исследование с одним скриптом и одним AI-модератором, поэтому необходима репликация. В следующей статье серии исследователи оценят, насколько хорошо AI и человек раскрывают известные факты об участниках, которые никогда не назывались в интервью напрямую.