Stanford: фреймворк для интеграции LLM в качественные исследования
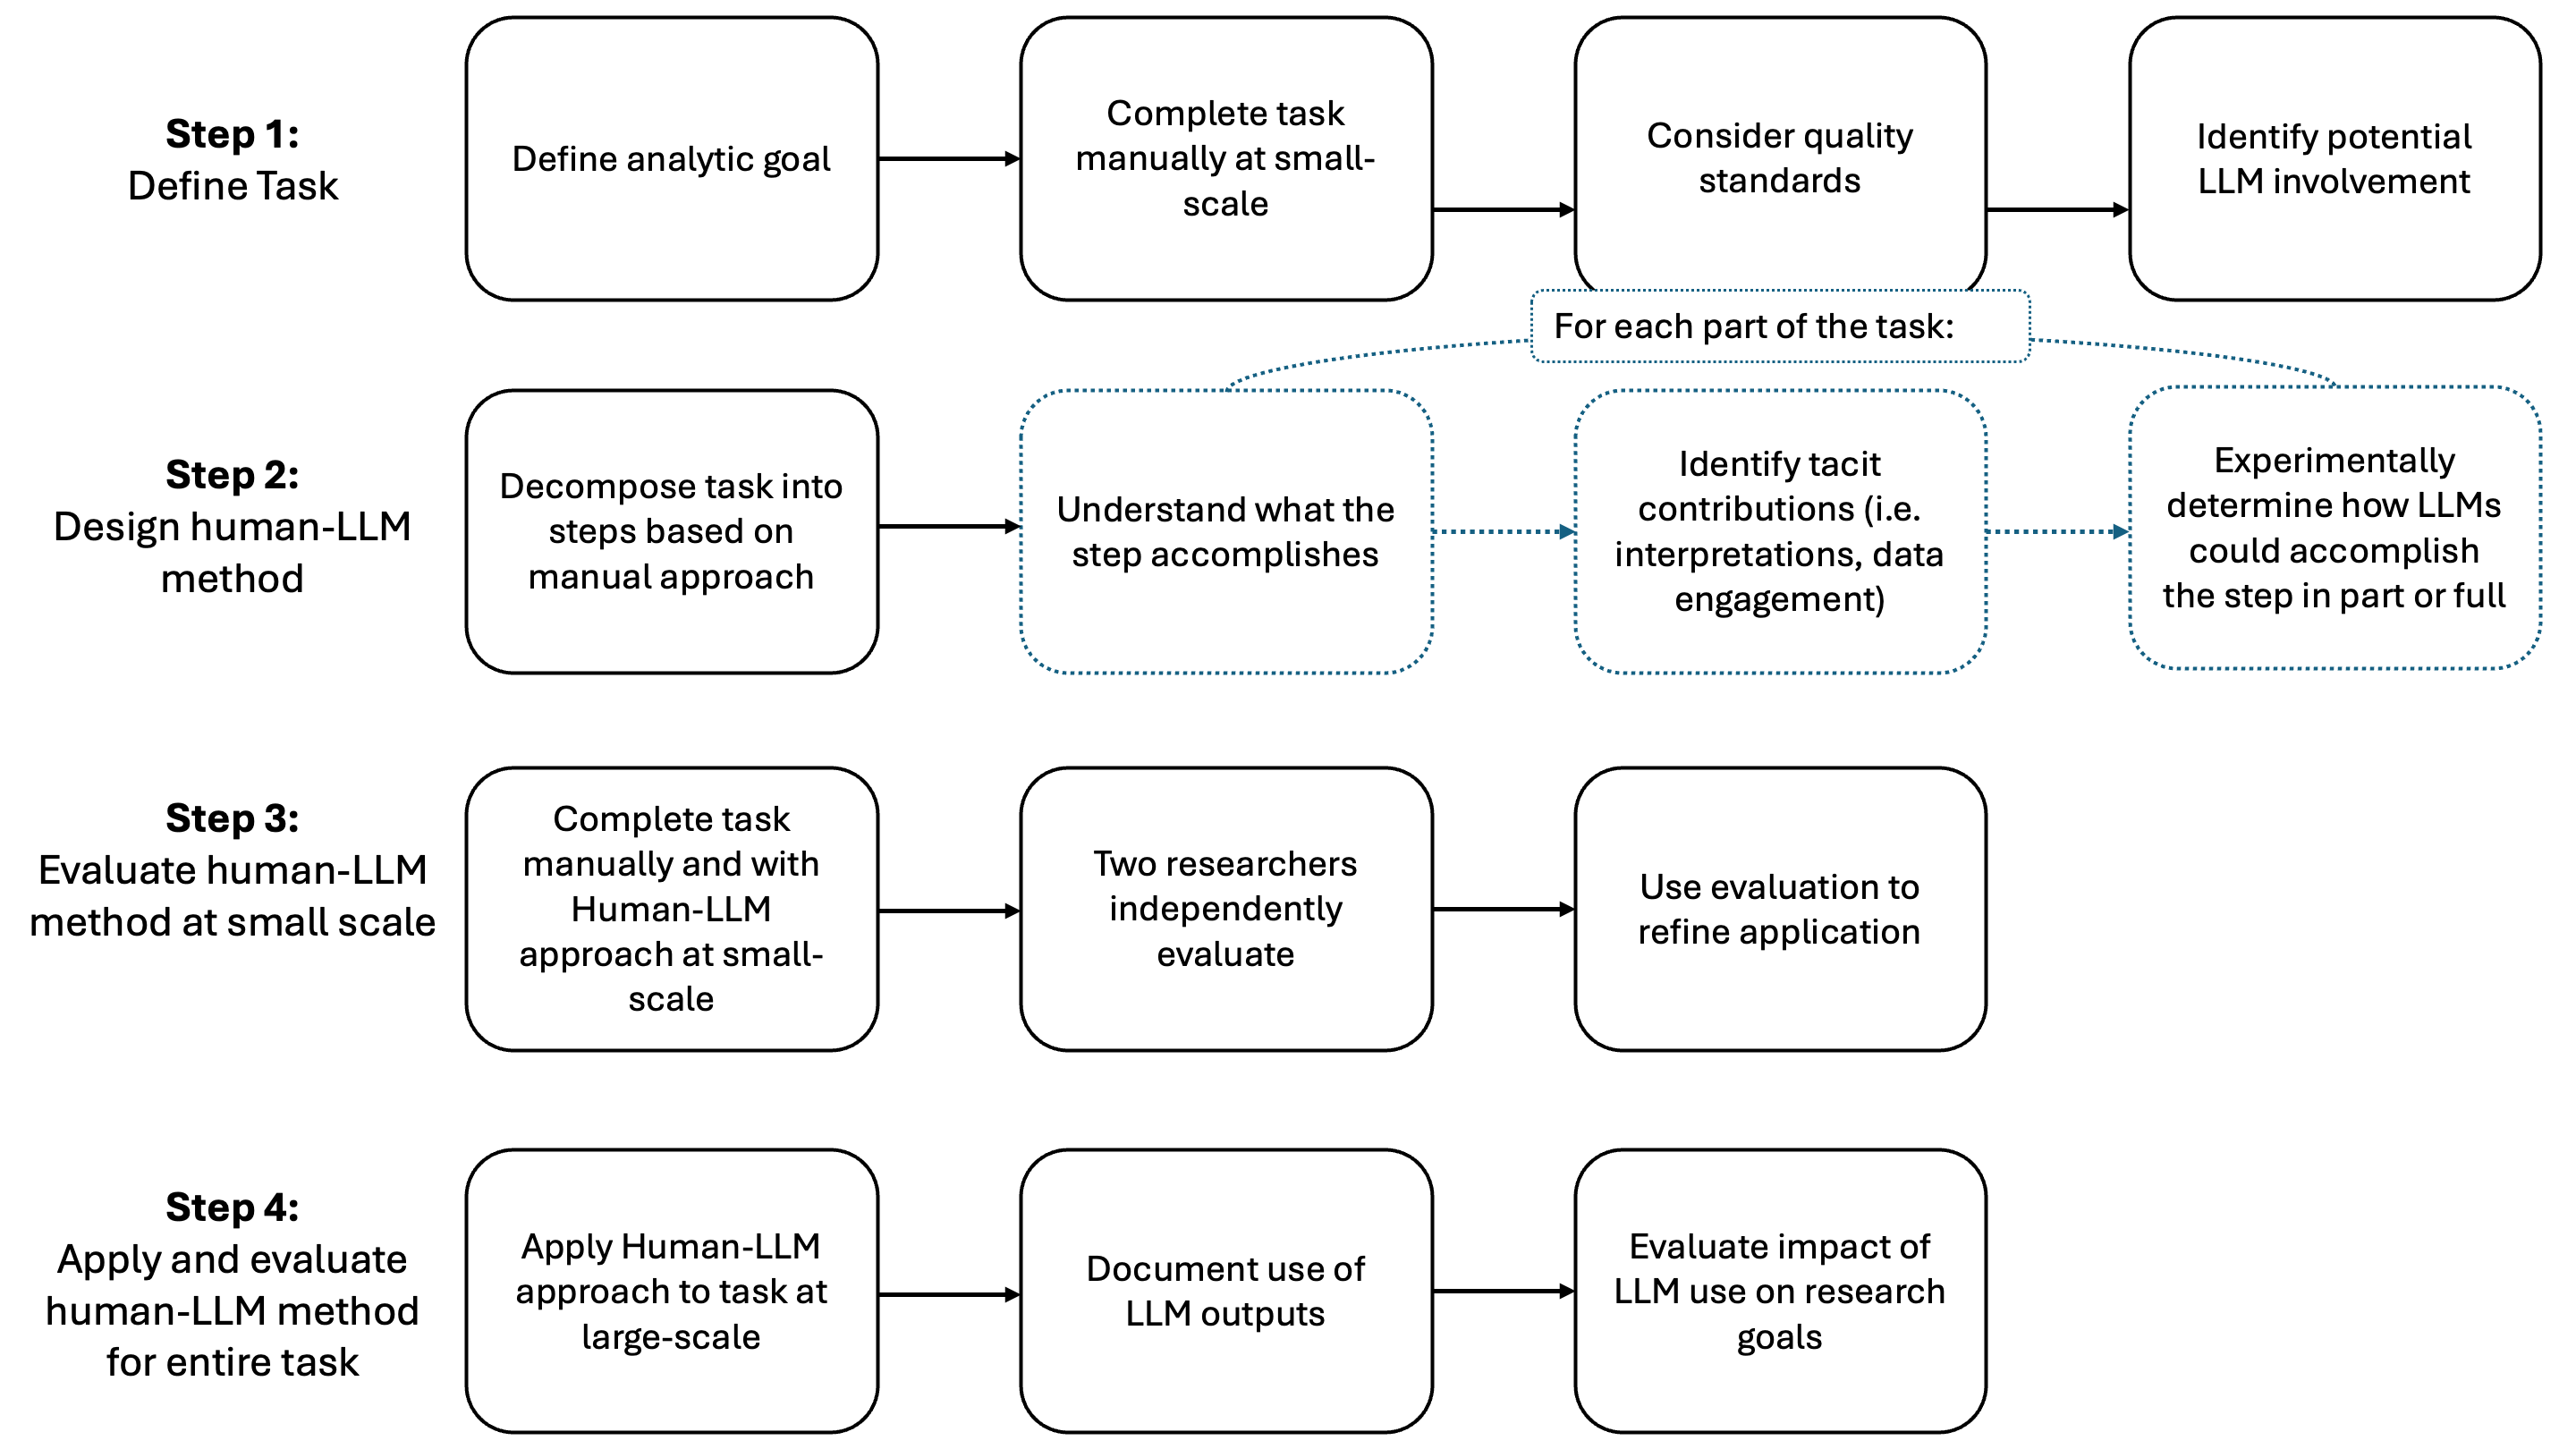
Группа исследователей из Стэнфордского университета и Гарварда опубликовала статью о методологии интеграции больших языковых моделей в крупномасштабный качественный анализ. Работа отвечает на практический вопрос: как использовать LLM не как замену аналитика, а как инструмент, который ускоряет процесс, сохраняя методологическую строгость и прозрачность.
Контекст и проблема
Качественные методы незаменимы в исследованиях в области здравоохранения: они позволяют выявлять личный опыт пациентов, организационную динамику и контекстные факторы, влияющие на оказание медицинской помощи. Однако крупные многосайтовые исследования часто выходят за рамки доступных ресурсов — анализ сотен интервью требует месяцев работы, а выводы должны поступать к практикам своевременно, пока остаются актуальными.
LLM теоретически могут ускорить этот процесс. Проблема в том, что использование универсальных чат-интерфейсов вроде ChatGPT для анализа качественных данных снижает методологическую прозрачность и рискует превратить глубокий интерпретативный анализ в поверхностную классификацию. Авторы фиксируют, что методологических руководств по встраиванию LLM в реальные рабочие процессы качественного исследования практически нет.
Фреймворк
Авторы предложили модель- и задаче-агностический фреймворк, состоящий из четырёх шагов:
Шаг 1. Определение задачи. Исследователи вручную выполняют задачу на небольшой выборке данных, чтобы уточнить цели, зафиксировать формат вывода, описать рабочий процесс и установить стандарты качества. На этом этапе определяются компоненты, которые обязательно должны выполняться живыми исследователями.
Шаг 2. Проектирование метода human-LLM. Задача разбивается на дискретные части. Для каждой части формулируется: какова её цель, какой неявный вклад вносит исследователь (например, применение контекстуального суждения или опора на знание предметной области), и целесообразно ли здесь использование LLM.
Шаг 3. Оценка метода на малой выборке. Два исследователя сравнивают результаты, полученные с LLM и без, на небольшом наборе данных. Поскольку в качественных исследованиях нет единого «золотого стандарта», оценка производится по критериям методологической строгости: соответствие данным, интеграция теории и эмпирики, связь с исследовательским вопросом, практическая значимость.
Шаг 4. Применение и оценка для всей задачи. Метод масштабируется на полный датасет.
Применение: исследование диабетической помощи
Фреймворк был применён в рамках многосайтового исследования организации помощи при диабете второго типа в 12 клиниках FQHC (Federally Qualified Health Centers) в Калифорнии, Огайо, Массачусетсе и Пуэрто-Рико. Исследование охватывало 167 интервью с врачами, административными сотрудниками, представителями пациентов и другими стейкхолдерами — суммарно около 1 327 000 слов транскриптов.
Авторы применяли LLM для двух аналитических задач.
Задача 1. Качественный синтез для подготовки сравнительных отчётов по каждой клинике. Исследователи создавали тематические резюме по каждому сайту; LLM организовывала эти резюме по доменам и строила тематические группы для кросс-сайтного синтеза. Финальную интерпретацию и формулировки всегда выполняли исследователи. Оказалось, что LLM-версии кросс-сайтного синтеза не подходили как конечный результат, но помогали исследователям получить полную картину данных и убедиться, что ни одна информация не была упущена.
Задача 2. Дедуктивное кодирование 167 транскриптов для уточнения интервенционной программы. Исследователи разработали систему кодирования из 19 семантических кодов, покрывающих практики организации помощи. Для каждого кода формулировались sub-вопросы, к ним добавлялись дополнительные вопросы для контроля систематических смещений (предвзятость примеров, предвзятость позитивности). Далее применялся Retrieval Augmented Generation: векторный поиск извлекал релевантные фрагменты транскриптов, а LLM отвечала на sub-вопросы, опираясь только на эти фрагменты. Автоматический скрипт объединял результаты, удалял дубликаты цитат и валидировал их наличие в исходных текстах.
Ключевые наблюдения
LLM-синтез оказался менее точным в доменах, где практики сильно варьировались по сайтам и где исследователи опирались на специфичный контекст при организации тем. При кросс-сайтном синтезе LLM иногда включала данные, которые исследователи относили к другому домену. Авторы приходят к выводу, что LLM ускоряет первичную организацию данных и снижает когнитивную нагрузку, но финальные интерпретации необходимо оставлять за исследователями.
В задаче дедуктивного кодирования LLM существенно сократила время обработки 167 транскриптов, позволив команде из более чем 35 исследователей предоставлять обратную связь практикам в разумные сроки.
Значимость для исследовательских команд
Статья предлагает операционализированный подход к работе с LLM в качественном анализе: не «использовать ChatGPT для анализа интервью», а систематически распределять ответственность между человеком и моделью на уровне конкретных подзадач. Это особенно актуально для команд, которые работают с большими объёмами качественных данных — транскриптами, опросами открытого типа, полевыми записями — и ищут способ ускорить анализ, не ставя под угрозу его достоверность.