arXiv: протестируй что-если сценарии до релиза — симуляция персон для принятия решений
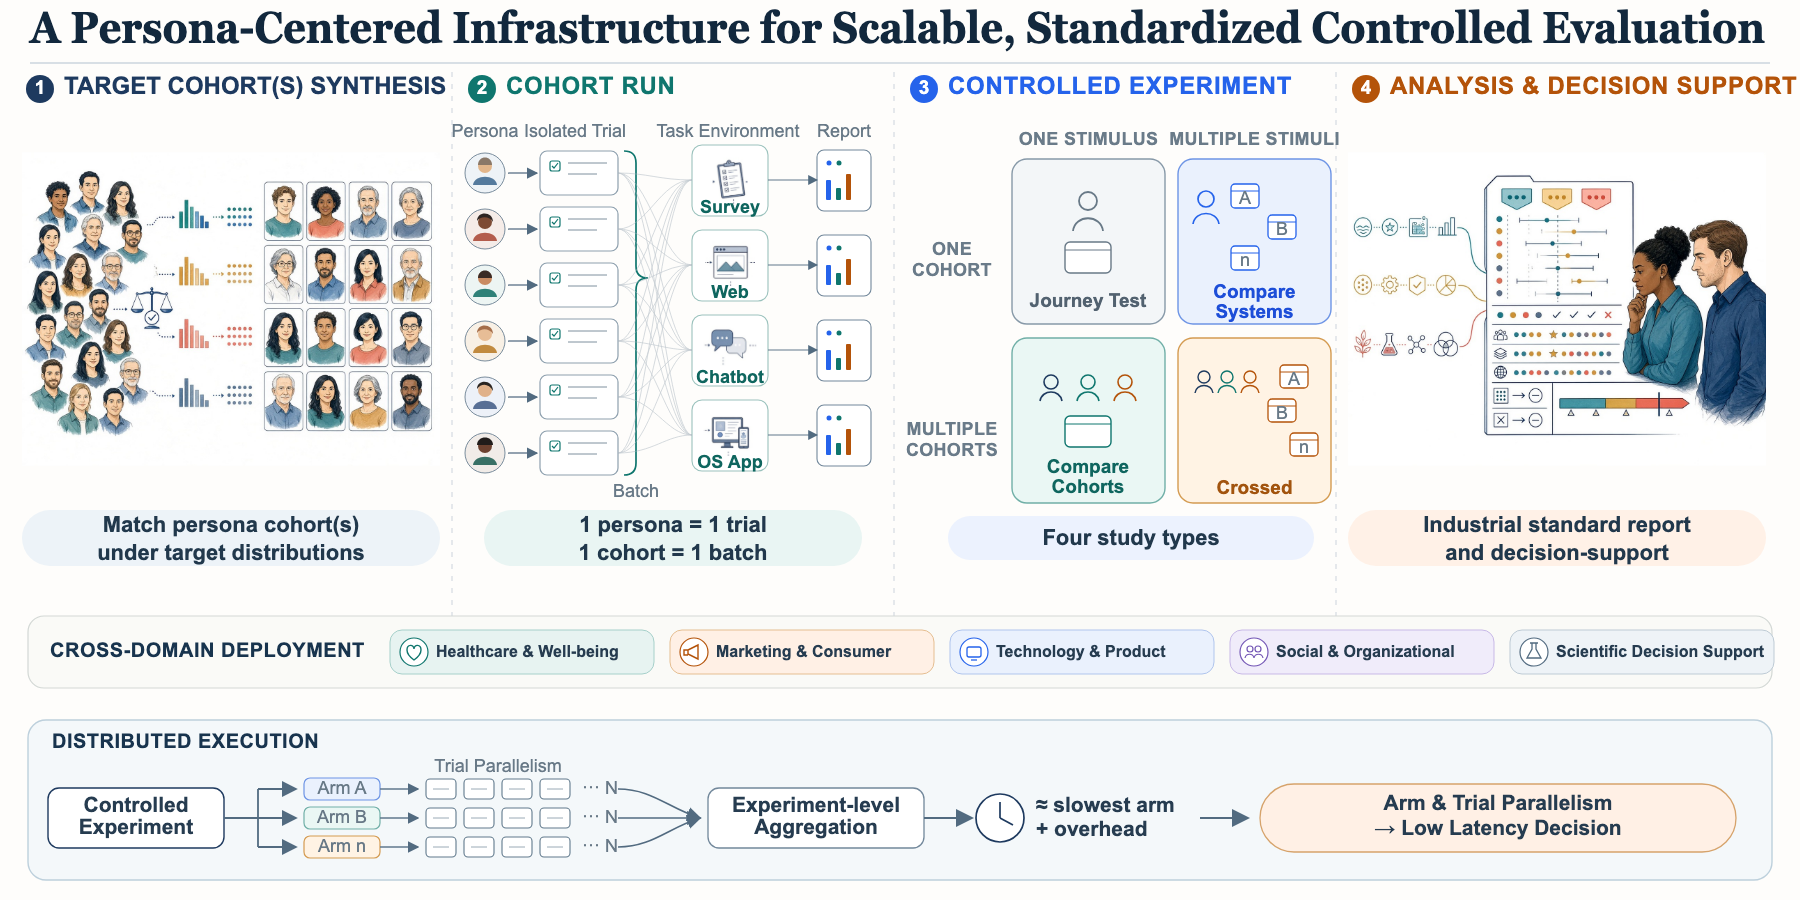
Исследователи из нескольких университетов и индустриальных партнёров опубликовали препринт, описывающий систему для проведения контролируемых экспериментов с симулированными пользователями. Работа адресована трём структурным проблемам живых исследований: сложность рекрутинга специализированных когорт, невозможность изолировать эффект отдельного атрибута пользователя в смешанных популяциях и риск экспозиции реальных клиентов незрелому дизайну или политикам.
Методология
Авторы формализуют постановку исследовательского вопроса через три оси: целевая когорта (кто), стимул (что оценивается) и метрики, релевантные для решения. Персона в этой системе — набор атрибутов, кондиционирующих поведение языковой модели через агентский обвяз; когорта — коллекция таких персон. Эксперименты классифицируются по двум осям: варьируется ли когорта и варьируется ли стимул. Фиксированная когорта с варьируемым стимулом — это System Under Test (SUT); фиксированный стимул с варьируемой когортой — Persona Under Test (PUT); пересечённый дизайн позволяет оценивать взаимодействия между ними.
Когорты строятся на основе корпуса из 1290 атрибутных измерений, зависимости между которыми закодированы в направленном ациклическом графе. Авторы описывают пять стратегий компоновки: выборка с опорой на референсные данные, сбалансированное сравнение, целевое оверсэмплирование редких групп, широкое покрытие и стресс-тестирование — увеличение доли персон, сталкивающихся с релевантными трудностями.
Инфраструктура поддерживает масштабное параллельное выполнение экспериментов по четырём типам сред: опрос (survey), веб-сессия, чат-бот и OS-приложение. Каждый прогон сохраняет персону, все отрисованные входы, ответ или траекторию взаимодействия и структурированный результат — с привязкой к исходным записям для аудита.
Двенадцать индустриальных кейсов
Авторы демонстрируют систему на двенадцати партнёрских исследованиях в пяти доменах.
Здоровье и благополучие. Онбординг музыкального сервиса (C1): вопрос о самочувствии пользователя вызывал больше доверия, чем акцент на научной базе или имитация тона «равного». Доступность медицинской помощи (C10): 900 симулированных персон по девяти стратам регион/возраст в Индии — жители сельских районов чаще сталкивались с транспортными барьерами, а взрослые 31–50 лет — с временны́м давлением.
Маркетинг и потребительское поведение. Подписная модель (C3): дешёвый вводный оффер привлекал интерес, но повторяющийся платёж тормозил подписку. Маркетплейс удалённых сервисов (C5): пользователи больше беспокоились о доверии к исполнителю, чем о цене. Оценка письма об условиях сотрудничества (C9): пересмотр пунктов об оплате и ответственности улучшал готовность подписать, но недоверие оставалось.
Технологии и продуктовый дизайн. Регистрация в профессиональной сети (C6): ~98% персон дошли до страницы регистрации, но только ~1% заявили о готовности завершить её — из-за опасений насчёт верификации личности и хранения документов. Промышленный сайт (C8): посетители охотнее изучали контент, чем обращались в отдел продаж; ссылка «попробуй бесплатно» вела к форме продаж, которая не оправдывала ожиданий.
Социальные и организационные исследования. Ответы на корпоративный опрос (C7): работники давали более благоприятные оценки в поддерживающих рабочих средах; смена модели симуляции меняла ответы сильнее, чем повторный запуск той же модели.
Научные исследования. Скрининг клинических испытаний (C2): онкологические фармацевты приоритизировали совместимость препаратов, молекулярные специалисты — генетическое подтверждение при идентичном исходном материале. Приоритизация исследовательских вопросов в иммунологии (C4): четыре профессиональные группы выбирали разные направления при одинаковых оценках понимания задачи.
Анализ устойчивости
Авторы сравнивают результаты на GPT-5.6-Sol, Claude Opus 5 и Gemini 3.7 Flash. По их наблюдениям, основные направления выводов воспроизводятся между моделями, тогда как величина эффектов может расходиться. Изменение или удаление атрибутов персоны меняет результаты сервиса, размеры эффектов и межгрупповые различия — это подтверждает, что детальная проработка персон существенно влияет на результаты симуляции.
Позиция авторов
Статья явно формулирует ограничения: кейсы устанавливают конкретные цели или направления для последующего тестирования с реальными пользователями, но не валидированные предсказания поведения живых людей. Система позиционируется как инструмент ускорения итераций и фокусировки гипотез перед первичным исследованием, а не замена ему.
Инфраструктура открыта в виде open-source; авторы публикуют протоколы и результаты всех двенадцати кейсов в приложении.