Springer: как LLM справляются с кодированием, тематизацией и выбором цитат в качественных исследованиях здоровья
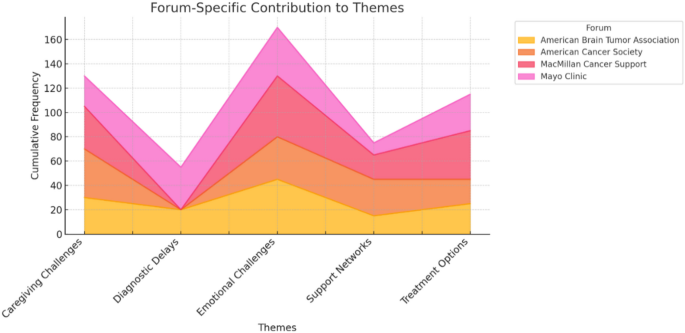
В марте 2026 года в журнале Discover Artificial Intelligence (Springer Nature) вышла рецензируемая статья, в которой три исследователя из американских университетов проверяли, как GPT-4 и Claude справляются с ключевыми этапами качественного анализа: кодированием, выделением тем, отбором репрезентативных цитат и визуализацией данных. Материалом послужили текстовые данные с четырёх онлайн-форумов поддержки людей с опухолями головного мозга — суммарно около 47 800 слов.
Методика
Исследователи последовательно загружали данные с каждого форума в оба LLM и задавали одинаковые запросы: определить коды и темы, найти репрезентативные цитаты к каждой теме, предложить пять фигур для визуализации данных. Диалог велся в рамках одной сессии без перезапуска, чтобы модели сохраняли контекст между форумами. Результаты сравнивались с применённым тематическим анализом, который команда провела вручную в более раннем исследовании.
Что показало сравнение
Кодирование. Оба LLM сгенерировали меньше кодов и с меньшей детализацией, чем ручной анализ. GPT-4 предложил меньше кодов, чем Claude, но снабдил их более развёрнутыми описательными субтемами — например, «сложности управления болью» вместо обобщённого «боль». Многие коды в целом совпали во всех трёх методах, хотя термины различались.
Темы. Общие паттерны — эмоциональные реакции, социальные связи, опыт взаимодействия с системой здравоохранения — были выявлены всеми тремя методами, но акценты различались. GPT-4 включал обсуждение ориентации на будущее, которого не было у Claude; Claude, в свою очередь, единственным выделил отдельную тему «признание маленьких побед». В анализе ошибок обе модели показали наибольшее расхождение с ручным анализом в функциональных категориях: информационные и коммуникационные трудности, практические и логистические задачи.
Отбор цитат. Здесь разрыв оказался заметнее всего. GPT-4 отдавал предпочтение эмоциональным, личным, нарративно-богатым высказываниям — его выбор цитат был наиболее близок к человеческому. Claude выбирал цитаты более структурированно и ориентировался на конкретику: симптомы, препятствия в системе здравоохранения, практические стратегии адаптации. Разница хорошо заметна при сравнении двух цитат к теме ухода за пациентом: GPT-4 выбрал высказывание об эмоциональном выгорании и жертвах, Claude — о навигации в системе медицинских выплат и финансовых трудностях.
Визуализация. GPT-4 сделал акцент на сравнительном анализе между форумами и визуализировал распределение тональности (sentiment polarity) по темам. Claude визуализировал субтемы внутри основных тем. Оба отличались от традиционных диаграмм и таблиц, характерных для качественных исследований.
Практический вывод
Статья не формулирует однозначного вывода «используйте это вместо ручного анализа». Авторы описывают LLM как инструмент дополнения, а не замены: ускорение начального кодирования, проверка устойчивости тем, генерация визуальных гипотез. Ключевое условие — итеративная обратная связь от исследователя, которая помогает уточнять результаты.
Для исследователей, работающих с большими корпусами качественных данных, статья содержит полезный операциональный материал: конкретные промпты, описание итеративного процесса, примеры ошибок обеих моделей. GPT-4 оказался ближе к человеческому стилю интерпретации, Claude — более систематичным и клинически ориентированным. Какой из этих профилей полезнее — зависит от задачи исследования.
Для кого это полезно
Статья будет интересна качественным исследователям в UX, CX, социальных науках и здравоохранении, которые уже используют или рассматривают использование LLM для анализа интервью и фокус-групп. Академические исследователи найдут здесь детальную методологическую базу; практики — конкретные примеры промптов и описание расхождений между моделями.